文章目录
交易系统中的 C++ 网络编程(TCP篇) 交易系统中的 C++ 网络编程(TCP篇) 交易系统中的 C++ 网络编程(TCP篇)
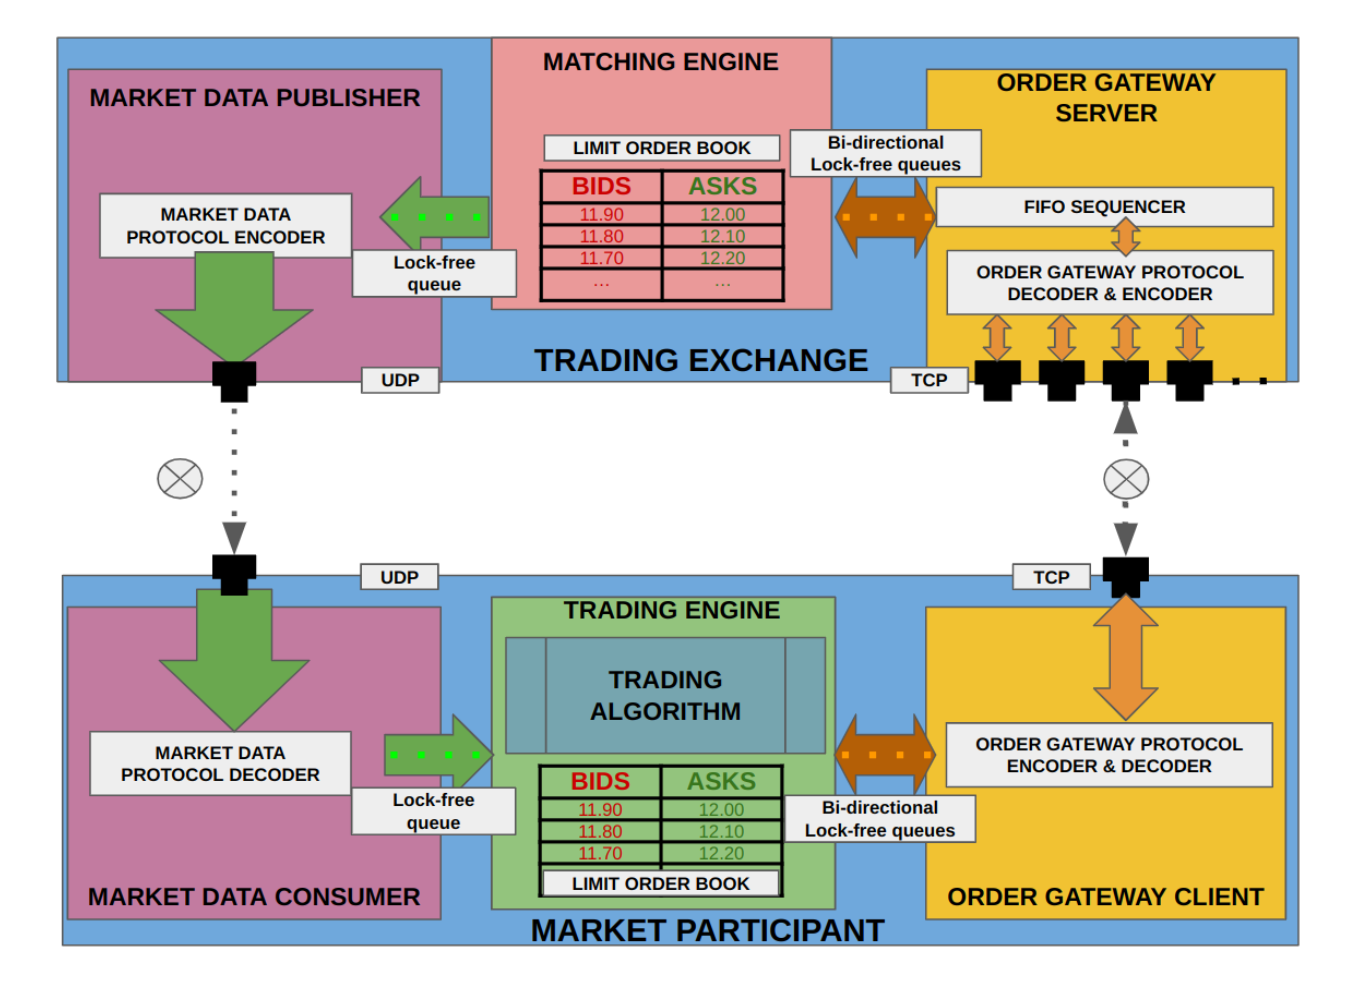
回顾一下这章交易系统拓扑图:在左边的行情传输部分通常使用 UDP,而右边的订单数据传输部分通常使用 TCP。本篇笔记主要关注右侧订单传输部分。
建立连接
客户端一侧
右侧负责传输订单信息的部分,使用 TCP 协议。下方是 MARKET PARTICIPANT 侧。作为 TCP 连接的客户端,它需要完成:
- 调用 socket() 创建一个客户端 socket fd;
- 配置 O_NONBLOCK、TCP_NODELAY 等;
- 调用 connect() 连接交易所;
- 连接成功后,把订单编码成协议消息;
- 通过 send() 发给交易所;
- 通过 recv() 接收订单确认、成交回报等。
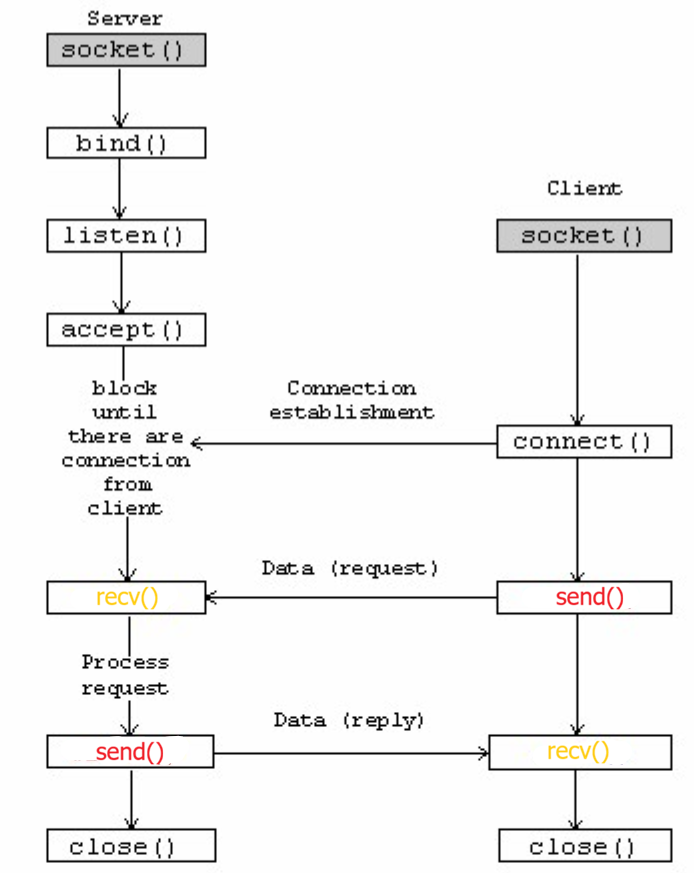
以下详细说明:
- 获取创建 socket 所需要的信息
- 通常使用
getaddrinfo()这个 Linux API,它返回的是一个链表,链表中每个节点是struct addrinfo结构体 getaddrinfo(node, service, hints, &res)的参数,可以获取远端信息,也可也获取本地信息。connect() 使用的是远端信息;bind() 使用的是本地信息。addrinfo的名字具有误导性,它不只是地址结构体,而是可用于创建 socket 的候选方案,因此除了地址信息之外,还包含协议信息- 每个
struct addrinfo结构体节点通常包含以下信息:ai_addr: 真正的 socket 地址结构体,包含 IP 地址和端口。IPv4 时是struct sockaddr_in,IPv6 时是struct sockaddr_in6ai_addrlen: ai_addr 指向的地址结构长度。IPv4 时它通常对应 sizeof(struct sockaddr_in),IPv6 时对应 sizeof(struct sockaddr_in6)ai_family:AF_INET表示 IPv4,AF_INET6表示 IPv6ai_socktype: socket 类型,SOCK_STREAM用于 TCP;SOCK_DGRAM用于 UDPai_protocol: 传输层协议,通常与 socket 类型对应。IPPROTO_TCP表示 TCP;IPPROTO_UDP表示 UDP
- 这里相当于一次性获取了 socket() 和 connect() 或 bind() 要使用到的信息
- ai_family / ai_socktype / ai_protocol 这些给 socket() 使用
- ai_addr / ai_addrlen 这些给 connect() 或 bind() 使用
- connect() 使用的是远端的地址信息;bind() 使用的是本地的地址信息
- 以上的 ai 前缀表示 addrinfo
- 一般需要遍历整个链表,直到找到成功的候选地址,成功通常涉及:
- socket() 创建成功
- connect() 或者 bind() 成功(取决于客户端还是服务端)
- socket() 创建 socket
int fd = socket(AF_INET, SOCK_STREAM, IPPROTO_TCP);
- 为降低延迟,配置 socket
fcntl(fd, F_SETFL, O_NONBLOCK);               // 设置非阻塞模式
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY, ...) // 禁用 Nagle 算法
setsockopt(fd, SOL_SOCKET, SO_TIMESTAMP, ...) // 为每个包加上时间戳
- connect(fd, 远端地址) 请求与服务器建立连接
-
返回值为 0 表示连接成功
-
返回值为 -1 表示失败,具体原因要看
errno。 -
常见
errno:EINPROGRESS: 正在连接中,不算最终失败ETIMEDOUT: 连接超时- … 还有很多
-
如果 errno == EINPROGRESS:
- 等待 epoll 可写(之所以不是可读,是因为连接成功后,对端不一定会立刻发送数据)
- 调用
getsockopt(fd, SOL_SOCKET, SO_ERROR, ...) - 返回值为 0 表示
getsockopt()的系统调用成功了,继续查看 SO_ERROR - SO_ERROR 当中记录 socket 的异步错误信息
- 如果 SO_ERROR == 0 表示没有错误信息,即 socket 的 connect() 成功了
-
注意区分
errno和SO_ERROR:errno记录刚刚那个系统调用为什么失败SO_ERROR是这个 socket 的异步错误信息
- send() / recv() 与服务器互发消息
ssize_t n_sent = send(fd, buf, len, 0);   // n_sent 表示本次实际发送了多少字节。-1 表示发送失败
ssize_t n_recv = recv(fd, buf, size, 0);  // n_recv 表示本次收到多少字节
需要注意,TCP 是字节流,不会保存消息边界,因此程序通常需要自己设计协议,比如 [消息长度][消息内容]。也即是图1中的 ORDER GATEWAY PROTOCOL ENCODER & DECODER 。它负责把内部订单对象转换成字节,或者把字节还原成订单回报。这些是应用层关心的,在本篇笔记内不展开。
服务器一侧
区分两种 fd,监听 fd 和连接 fd
- 监听 fd 负责对新的客户端连接调用 accept()
- 连接 fd 负责与客户端 socket 互发消息
交易所作为 TCP 连接的服务器,需要完成:
- 通过 socket() 创建一个 socket 并得到其 fd
- 通过 bind() 将上述 fd 绑定到服务器机器上一个 IP 地址和端口
- 服务器必须让客户端直到 “请连接这台机器的这个 IP 和这个端口”,因此服务器需要显式将 fd 绑定到 IP 和端口上
- 而客户端可以不 bind(),因为服务器不需要主动寻找客户端。
- 当 connect() 执行时,操作系统会为客户端分配临时 IP 地址和端口
- 如果期望客户端每次连接都从同一个 IP 地址和端口发出,则可以显式 bind()
bind(fd, 本机地址和端口);
- 监听 fd 负责通过 listen() 持续监听客户端连接
listen(listen_fd);
- 监听 fd 在收到客户端连接之后,调用 accept(),使得某个连接 fd 与客户端建立连接
connection_fd = accept(listen_fd)
实际交易程序通常会在服务器进程中创建一个 epoll 实例,用它同时管理监听 fd 和多个已建立连接的服务器端连接 fd:
- 监听 fd 出现可读事件时,表示连接队列中可能有新的客户端连接,调用 accept()
- 某个服务器端连接 fd 出现可读事件时,表示客户端已经发送了数据,调用 recv() 读取;如果读到 0,表示客户端已经关闭连接。
- 某个服务器端连接 fd 出现可写事件时,表示内核发送缓冲区有空间;如果应用发送缓冲区中还有未发送数据,调用 send() 继续发送。
低延迟思想
- 避免阻塞:使用 non-blocking
- 避免一个线程对应一个连接:使用 epoll
- 减少小 TCP 消息的发送等待:关闭 Nagle 算法
- 记录数据到达时刻:SO_TIMESTAMP
- 减少传统网络栈路径的额外开销:kernel bypass
使用 non-blocking 避免阻塞
non-blocking 是 socket 的一种属性。设置后,读写操作不能长时间等待;在 blocking 模式下,recv() 如果没有数据的话会一直等待;non-blocking 模式下,recv() 如果当前没有数据就立即返回,告知调用者 “现在无数据”
non-blocking 通常和 epoll 一起用:
- 如果有 epoll 但是没有 non-blocking:epoll 告诉你 fd 可读,但是 recv 可能阻塞
- 如果有 non-blocking 但是没用 epoll:fd 不会阻塞,但是不知道何时该重试
设置 non-blocking 的方法:
int flags = fcntl(fd, F_GETFL, 0);       // 获取该 fd 原本的 flags
fcntl(fd, F_SETFL, flags | O_NONBLOCK);  // 保留原本的 flags,并额外打开 O_NONBLOCK 这一位
这里的 fcntl 是 file control 的意思,用于读取或修改 fd 的属性
设置 non-blocking 之后,如何调用 recv():
- 根据 recv() 的返回值来判断操作状态
- n > 0 表示读到了 n 字节
- n == 0 表示对端关闭
- n == -1 表示错误
- 在 n == -1 的情况下,查看 errno 来判断具体错误
- errno 是整数错误码,独立于 recv() 的返回值,用于记录失败细节。这是 POSIX API 的机制
- errno 是线程局部变量,因此多个线程不会相互覆盖
- errno == EAGAIN / EWOULDBLOCK 表示 “当前不能读,之后再试”
- errno == ECONNRESET 表示 “对端异常重置了连接”
- errno == EBADF 表示 “fd 无效”
使用 epoll 避免一个线程对应一个连接
通过 epoll 实现 IO multiplexing:希望一个线程可以管理监听 fd 和大量连接 fd。在没有 epoll 时,accept(listen_fd), recv(connection_fd_1), recv(connection_fd_2) 等等这些 blocking socket 只能按顺序处理;epoll 避免因某个没有事件的 blocking fd 而卡住整个事件循环。
监听 socket 上和连接 socket 上使用 epoll 的机制是不同的,但是它们可以放在同一个 epoll 实例里:
在监听 socket 上使用 epoll
- 将 listen_fd 注册到 epoll
- epoll_wait() 报告 listen_fd 可读
- accept(listen_fd)
- 得到 connection_fd
在连接 socket 上使用 epoll:
- 将 connection_fd 注册到 epoll
- epoll_wait()
- connection_fd 可读
- recv(connection_fd, …)
关闭 Nagle 算法以减少小 TCP 消息发送等待
假设应用频繁发送很小的数据,如果每次都立即发送,就会产生很多小 TCP 包,每个包都有 header,导致网络利用率较低。Nagle 算法会尝试暂时缓存小块数据,等待已有数据积累到较大的数据块再发送出去,以此提高吞吐效率。
但是在低延迟交易系统当中我们要禁止 Nagle 算法。原因是在交易场景下,行情、订单、请求等消息可能很小,但是必须尽快发送。
关闭 Nagle 算法的方法:
setsockopt(fd, IPPROTO_TCP, TCP_NODELAY, ...);
此处 IPPROTO_TCP 表示此处设置的是 TCP 协议层的选项 TCP_NODELAY = 1 表示关闭 Nagle 算法
使用 SO_TIMESTAMP 记录数据到达时刻
让内核在收到网络数据并把它交给某个 socket 时,附带一个 “接收时间”
使得程序可以严格按照数据到达时间来处理数据。因为 epoll 只负责发现 fd 可读,但是 epoll 的唤醒顺序未必等于数据到达顺序。
启用方法:
int enabled = 1;
setsockopt(
    fd,
    SOL_SOCKET,
    SO_TIMESTAMP,
    &enabled,
    sizeof(enabled)
);
这里的 SO_TIMESTAMP 标志开启了接收时间戳
使用 recvmsg() 来接收数据: 相比于普通 recv(),recvmsg() 可以接收启用 SO_TIMESTAMP 后内核额外返回的控制信息
recvmsg(fd, &message, 0);
这里的 message 包含两类数据:
- 普通数据(应用协议 payload)
- 控制信息(时间戳等元数据)
使用 kernel bypass 减少传统网络栈路径的额外开销
让程序尽量绕过操作系统内核的传统网络数据路径,直接或通过专用用户专用用户态库与网卡交换数据,从而减少系统调用、上下文切换和内存复制
普通 socket send() 的路径:
- 应用程序
- send()
- 系统调用
- 内核 socket 缓冲区
- 内核 TCP/IP 协议栈
- 网卡驱动
- 网卡(NIC)
层数较多,保证安全,但是每一层都带来成本:
- 系统调用成本
- 上下文切换成本
- 内核缓冲区与应用缓冲区之间的数据复制
- 通用协议栈的检查、排队和调度
- 中断处理带来延迟抖动
- 多层锁和共享队列竞争
Kernel Bypass 实现了简化:
- 应用程序
- 用户态网络库
- 共享内存/环形队列
- 网卡(NIC)
这部分实现较为复杂,有以下支持 kernel bypass 的 NIC 和 API,此处不深入:
- Solarflare OpenOnload
- ef_vi
- TCPDirect
- Exablaze 的专用网卡方案