文章目录
C++:容器概述 C++:容器概述 C++:容器概述
有一些对于所有 container 都适用的操作,如图:
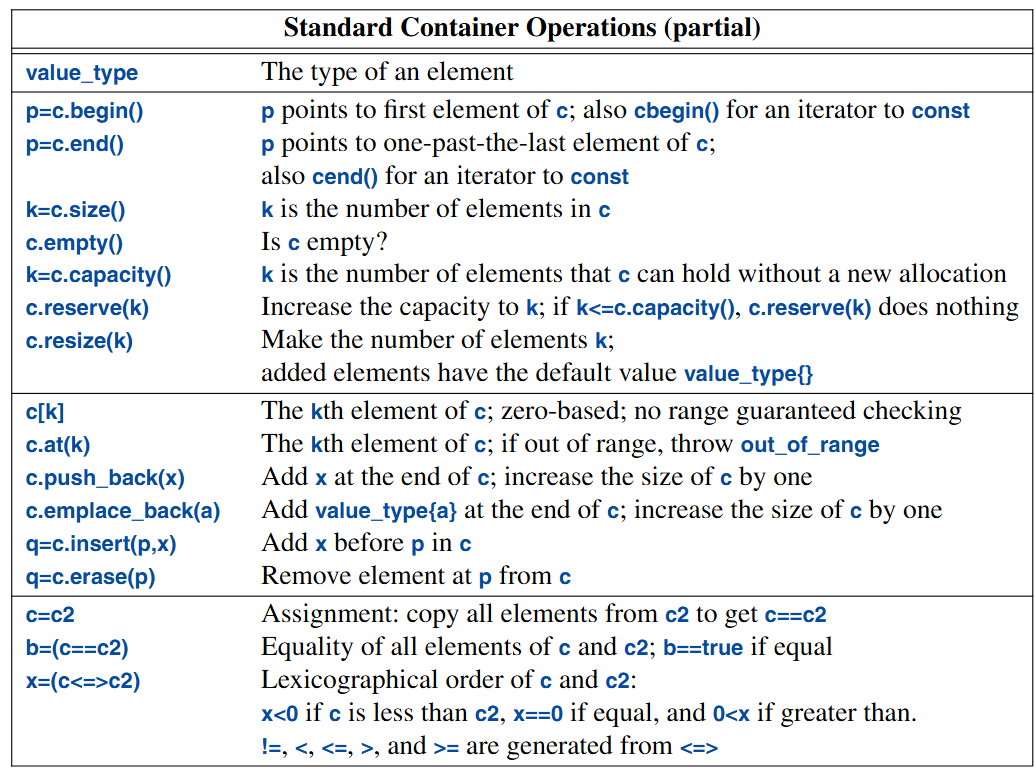
STL 除了有容器本身之外,还提供一些 container adaptors: std::queue<T>、std::stack<T>、std::priority_queue<T>,这些 adaptor 以其它容器为底层容器,只暴露受限接口。
std::vector
std::vector 的组成
std::vector 是元素句柄,不直接持有元素,而是持有指向元素的指针,这一点与 std::array 不同。一个典型的 vector 实现是三个指针:
elem指向第一个元素space指向 one-past-the-last elementlast一个指向 one-past-the-last-allocated-space
int vector::size() {
    return space - elem; // size() 是用指针 Offset 算出来的
}

int vector::capacity() {
    return last - space; // 剩余可分配的元素个数
}

void reserve(int new_size); // 把 capacity() 变为 new_size

void resize(int n);  // 把 vector 的 size() 调整为 n。若 n 更大则补充默认值元素,否则删元素
使用 reserve() 的时候,如果当前的连续存储空间不够大,则需要为 vector 分配一块新的内存,则原先指向这个 vector 的指针都需要更新,这些指针包括指向元素的指针、元素的引用、迭代器,但是不包括指向 vector 对象本身的指针,因为 vector 本身只是句柄。如果希望指向容器元素的指针始终有效,则应该考虑使用 std::list。
std::vector<int> v = {1, 2, 3};
auto* p = &v[0];
auto& r = v[0];
auto it = v.begin()
// 如果下面的 reserve() 重新分配了一块内存,则以上三个指针/引用/迭代器全部失效

auto* p1 = &v; // 指向 v 本身的指针不会失效,因为 v 只是句柄

v.reserve(100);
讲到分配内存,std::vector 通过它所持有的 allocator 来分配内存。allocator 用作容器与内存管理之间的 abstraction。std::vector<T> 使用 std::allocator<T> 来给元素分配内存。std::allocator<T> 会调用 new 和 delete 来分配、释放内存。
std::vector 的初始化
圆括号:
- 表示初始大小
std::vector<int> v(5) - 表示初始大小和初始值
std::vector<int> v(5, 1) - 使用迭代器来初始化
std::vector<int> v2(v1.begin(), v1.end())
花括号:
- 表示使用花括号内的元素序列来初始化 vector。
区分初始化时使用圆括号还是花括号的原则:
- 如果用 size 来初始化,就用圆括号
- 如果用一个元素序列来初始化,就用花括号
- 初始化一个空 vector 的时候建议用花括号
std::vector<int> v{}(因为圆括号很容易被误认为函数)
访问 std::vector 的元素
这里讲 subscripting [] 和 at() 两种访问元素的方式:
subscripting 的操作 [] 返回的是元素的引用,因此可以通过以下的方式修改容器中的值:
auto x& = v[1];
x = 5;   // 修改了 v 当中元素的值
at() 方法和 subscripting 大体一致,相较于 subscripting 的好处是,它会进行 range checking。如果超限,会抛出 std::out_of_range 错误。
之所以默认的 subscripting 不会进行 range checking 是由于这个操作太常见,而增加 range checking 会引入一些延迟。而且在需要时自己实现一个会 range check 的版本也不难。
push_back() 和 emplace_back()
push_back() 和 emplace_back() 都可以在 std::vector 尾部新增一个元素。它们的差别体现在:
push_back()接收一个已有的对象,提供拷贝或移动构造push_back()提供T& t和T&& t的重载,如果传入左值则调用拷贝构造;传入右值则调用移动构造emplace_back()会把参数完美转发给对象的构造函数,因此其接收的参数与对象构造函数完全一致
v.push_back(T{arg1, arg2}) 与 v.emplace_back(arg1, arg2) 的性能差异一般很小
push_back() 的实现:
template<typename T>
void std::vector<T>::push_back(T t) {
    if (capacity() < size()) { // 这里采用一种 heuristics,若剩余空间较少
        reserve(size() == 0 ? 8 : 2 * size()); // 重新分配使得剩余空间为当前 size() 的两倍
    }
    construct_at(space, t); // 这是在给定地址上构造元素的底层 API
    ++space;
}
如果剩余的空间比已有元素还要小,则重新分配空间,分配后的空余空间需要是已有元素的 2 倍(2 * size())。通常来说,不需要手动调用 reserve(),push_back() 的 heuristic 预分配空间已经足够好。
list
std::list 是标准库提供的双向链表实现。
Q1:既然标准库提供了 list 这一链表的实现,那么为什么在 BLLA 书中,仍然要手写订单簿当中的价格档位链表和同一价格下的订单 FIFO 链表?
A1:可能是追求低延迟。// TODO:我们可以调研一下在低延迟系统当中应当使用 std::list 还是手写链表
Q2:leetcode 当中的题目也是原始链表实现,而不是使用 list,点解? A2:因为 leetcode 想要考察你对于数据结构的理解
使用 std::list 的时候,不用像手写链表那样写 std::find_if(),而是可以正常遍历它,然后查找
std::list<Entry> phone_book;
for (auto x : phone_book) {
    if (x.name == "adrian") {
        std::cout << "gotcha!";
        break;
    }
}
如果想要在 std::list 当中增删一个节点的时候,通常会使用迭代器,方法大致如下:
for (auto it = phone_book.begin(), it != phone_book.end(), it++) {
    if (it->name == "adrian") {
        insert(it, {"123", "xv"});
    }
}
std::list::insert(p, elem):p 是一个指针/迭代器,elem 是要插入的对象(按值复制)。这个函数会在 p 之前的位置上插入一个值为 elem 的元素。
std::list::erase(p):p 是一个指针/迭代器,这个函数会把 p 指向的元素删除并释放内存。
std::forward_list
这是单向链表。它相比 std::list 的好处是节省空间,因为无需保存指向前一个元素的指针。
std::forward_list 本身非常轻量,一个空的 std::forward_list 只需保存一个指向头节点的指针。所以空容器对象本身占一个 word(在 64 位机器上就是 8 字节);而一个空 std::vector 要保存三个指针,因此一个空 std::vector 需要占据 3 个 word。因此,如果需要大量容器但是其中大部分容器为空或者元素很少,使用 std::forward_list 是较为高效的。
std::map
在 C++ 标准库中是没有 std::ordered_map 的,只有 std::map。
它的底层实现是一个平衡二叉搜索树,也就是一个红黑树。红黑树满足以下特质:
- 是一颗二叉搜索树,即满足 “左子树 < 当前节点 < 右子树”
- 每个节点还有一个 “红” 或 “黑” 的属性
- 根节点是黑色
- 红色节点不能有红色子节点
- 从一个节点到任意叶子节点的路径上,黑色节点数量相同
核心就是保持这颗二叉搜索树始终平衡,始终保持 O(log n) 的搜索时间复杂度(不像普通的二叉搜索树那样可能会退化成一条向左下方或者右下方的一个序列,造成 O(n))。
可以在 std::map 上使用和 std::vector 和 std::list 一样的初始化
map<string, int> phone_book {
    {"David", 12345},
    {"Adrian", 123},
    {"xv", 234}
};
在 std::map 上使用 subscripting 时,如果确实有这个条目,则会返回该条目;如果没有这个条目,则会插入一个以原 key 为 key,以默认值为 value 的条目。
因此,如果在一个 std::map 当中进行查找时,不想插入包含默认值的条目,使用 find() 更好。这里的 find() 是 O(log n)。
auto it = phone_book.find("Adrian");
if (it != phone_book.end()) {
    auto name = it->first; // 就是 key
    auto number = it->second; // 就是 value
}
还可以使用 std::find_if 来自定义横跨 key 和 value 的搜索条件。std::find_if 的时间复杂度是 O(n):
auto it = std::find_if(phone_book.begin(), phone_book.end(), [](const auto& p) {
    return p->first.starts_with("a") && p->second == 123;
})
遍历一个 std::map 的方法:
for (const auto& [key, value] : m) {
    auto k = key;
    value++;
}
这里使用了 const auto&,因此可以修改原 map 当中 value 的值。但是 key 是不可修改的。另外注意,std::map 当中只能针对 key 进行排序,不能针对 value 进行排序,因为 value 是可修改的,而 key 不可修改,排序需要依赖稳定的 key。
std::unordered_map
std::unordered_map 和 std::unordered_set 都是使用哈希的容器。
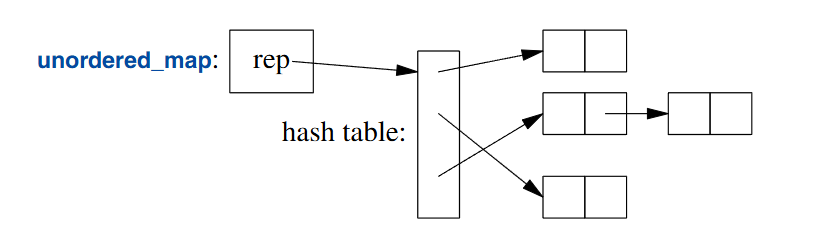
访问哈希容器当中的元素的流程大致是:
- 根据 key 计算
std::hash(key)得到一个 size_t 的 hash value - 再做一个简单的运算把 hash value 转成 bucket index
- 在哈希表当中的 bucket 数组当中获取 bucket index 对应的元素
哈希表当中存储 bucket 数组,bucket 数组内部存储真正的元素。对于 std::unordered_map 来说,真正的元素是 std::pair<const K, V>;对于 std::unordered_set 来说,真正的元素是 const K。但是具体哈希表、bucket 数组的内存布局由标准库实现决定,无需关心。
在没有发生哈希冲突的情况下,一个 bucket 里面只有一个元素。
总体来说,哈希容器之所以高效,就是用 “无序 + 额外空间” 换取平均 O(1) 的查找时间,只需简单计算即可找到元素。
标准库为 built-in tyoes 提供了哈希函数,所以一般不需要手写哈希函数。但是如果要以自定义对象为 key,则要手写哈希函数。以下是一个手写哈希函数的例子,这里使用一个函数对象来表示哈希函数:
struct Record {
    string name;
    int product_code;
};

struct Rhash { // 函数对象
    size_t operator()(const Record& r) const {
        return std::hash<string>()(r.name) ^ std::hash<int>()(r.product_code);
    }
};

bool Record::operator==(const Record& other) {
    return name == other.name && product_code == other.product_code;
}
这里使用了 std::hash 分别计算 r.name 和 r.product_code 两个哈希值,然后使用 ^ (异或XOR)来合并得到一个哈希值。
另外,在 std::unordered_map 当中的元素还要能够判等,因此还需手动定义 == 运算符。
撰写高效的哈希函数是一件很难的事情,哈希容器的效率就取决于哈希函数是否高效(上限高、下限低)。
std::map 需要元素之间可以排序,std::unordered_map 只要求元素之间可以判等
std::multimap, std::multiset
std::multimap 允许相同的 key 出现多次,可以使用 std::multimap::equal_range(key) 查询某个 key 对应的所有记录:
auto [begin, end] = m.equal_range("Alice");
for (auto it = begin; it != end; it++) {
    auto k = it->first;  // 获取 Key
    auto v = it->second; // 获取 Value
}
std::multiset 不是数学意义上的集合。它会自动保持有序,同时保留重复元素,适用于需要不断插入元素同时始终保持有序的情况。
allocators
Allocator 是 C++ 当中给容器申请和释放内存的一套机制
是容器(std::vector, std::map, std::list)和内存管理(operator new, 内存池)之间的一层抽象
因此可以自定义一个 allocator 用于内存池
// TODO:在 simex 和 jev-quant 当中编写一个适用于内存池的 allocator
由于容器保持通用性(元素类型作为模板参数),那么 allocator 作为容器与内存管理之间的一层抽象,同样要保持通用性(比如能够为任意大小的对象申请内存)。这种通用性可能会带来一些额外开销,比如动态分配的成本、频繁 new/delete 带来的开销等等。
因此当使用场景比较明确,不需要通用性的时候,可以自定义使用场景更明确、更高效的 allocator。典型的使用场景包括:
- 使用于内存池的 allocator
- 安全考量:比如先把内存清零再释放
- per-thread allocation:每个线程使用自己的内存池
- NUMA 架构:把数据分配到距离某个 CPU 更近的内存上